用 Codex 编程?我受不了了!
用 Codex 编程?我受不了了!
本文正文纯手打无 AI,题图源于网络和 GPT-image-2.5
目录
最近复盘了一下自己几个月以来使用 Codex 的过程,同时也用了几天 Claude Opus 5.5,越来越发觉 Codex、GPT 模型不好用。我认为根本原因在:
GPT 是一个极度过度防御、过度对齐,几乎到了魔怔的模型,为了把编程分拉高,不惜牺牲一切,造成了各种体验上的倒退。
下面从沟通和实际编码两个方面展开这种缺点
沟通体验的重要性
GPT 过度防御在沟通中体现淋漓尽致,用得多的人都知道,非常常见的口癖有:“我会区分一下 A 和 B”“不把 A 当成 B”“不把 A 说成 B”“不是 A,而是 B”“A 不能保证 B”等等。
即使你只提出 A,从未提到 B,它也会“避免你误解”,搬出来 B。总结就是防御防御再防御,严谨严谨再严谨。
这种看得想吐的句式。这不仅看起来很恶心,更重要的是,明明用户没有提到这一点,也没有任何即将产生误解的现象,这样的表达纯粹增大了理解成本。
有一次我忍无可忍,让它分析原因,结果它当场复现一次,令人忍俊不禁:
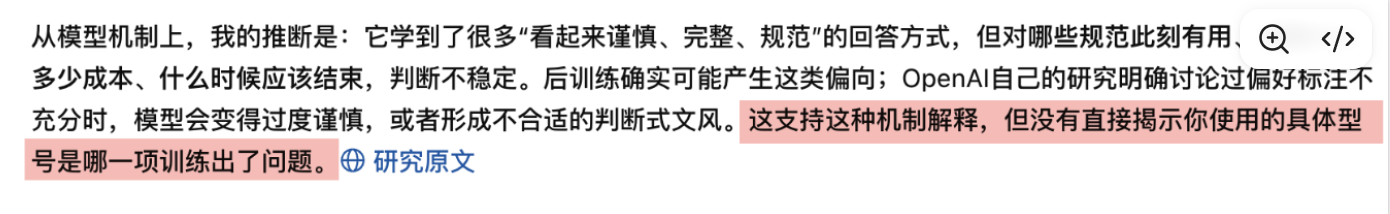
(我并没有提到我需要让它回答具体型号的具体问题)
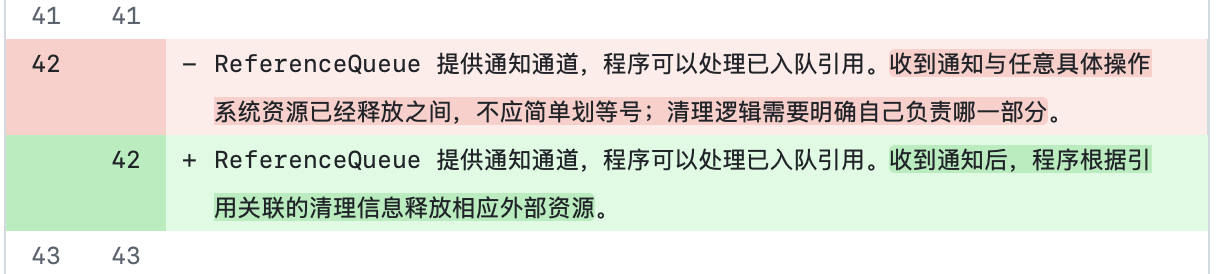
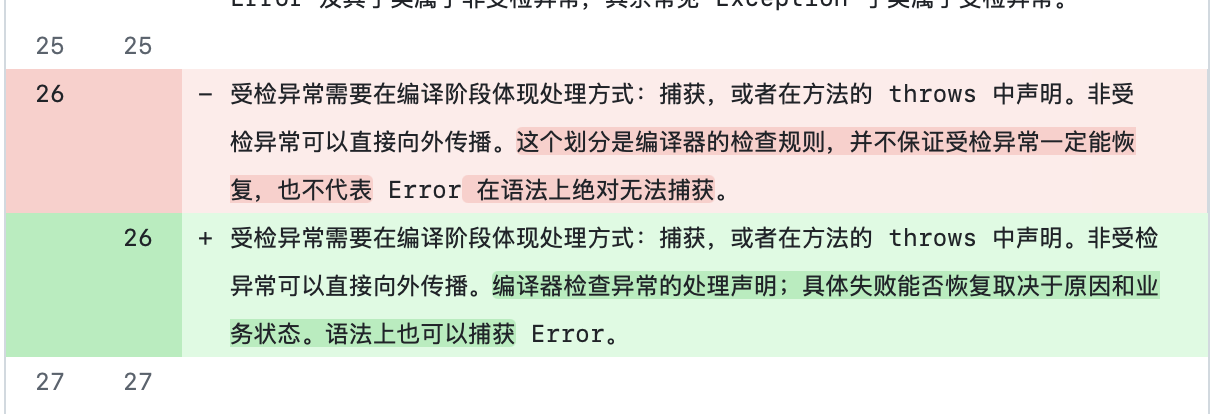
至于让它写文章,那就更是灾难,下面红色的修改前的文字就是原本它写的文字,频繁使用“不能划等号”“不保证”“不代表”之类的免责式语言。诸如此类简直数不胜数。
过度严谨对开发的影响
我说我要红烧肉,结果 GPT 做了红烧肉,另外又做了东坡肉放在旁边,说防止红烧肉出问题了,备用一个东坡肉。我说不要东坡肉,谁让你加的东坡肉?它马上删除,但还不满足,它说防止下次再出现东坡肉,于是加入测试,写入文档“此后不再做东坡肉”……,我说你删掉这些测试,删掉这些文档,这才作罢。此时已经浪费了无数的时间和 Token,情绪也受到打击。
于是下次我们说需求的时候极度谨慎,需要反复确认,经常一个小需求就要和它对半个小时才放心让它开始。否则它十有八九会做出雷霆大测试,大校验,大兜底。
另外,我还发现它对目标的理解非常差,不按常识理解。它非常执着于用户消息文字表面的意思,说一不二,即使从上下文和常识来看,我表达的明显是另一种意思(没错,执着用户表面意思和擅自加入各种过度设计和防御,是同时发生的,并行不悖),因此需要人非常精确地描述自己的需求,丝毫也不能偏差。
看到我的意思反复不能被人理解,或者被人曲解,我是会不高兴的。而且感到生气的同时,还会自我 PUA,觉得是不是我哪里表述不够清楚,反复修改提示词。 (PS:实际上后来用了 Claude,一切都好起来了,它一下就能 get 到我的想法和意思,还会给出建议,正是我想要做的事)
我想,被理解、被尊重、被听见,应该是每一个人都希望得到的体验。开发者也是人,也需要被认真对待,况且真正占据开发者每天大量时间的是和 AI 对话的过程。就算模型代码写得再好,但是过程却是一遍遍面对理解成本极高的垃圾语言,一遍遍被误解,一遍遍澄清需求,反正我是不会愿意做这样的交换的,况且产出的代码质量并没有多么高。
OpenAI 意识到了吗?
显然是意识到了,查看官方的 Codex 模型目录文件,其中有给 GPT-6.1-Sol 和 GPT-6-Astra 等模型的系统提示词,根据相关原文摘抄翻译如下:
- 限制“不是…而是…”等说法:
直接说明打算采取的行动。避免补充你不会做什么、哪些内容将保持不变,或你将如何分开、归类结果。不要使用“是 X,不是 Y”或“X——不是 Y”这类对照式表述,引入用户没有问到的另一种情况。避免自造复合标签,例如“exact-head checks”“editorial-row layouts”,也要避免含糊的限定语和模板化过渡句;用普通动词和介词直接说明实际关系。
- 限制 AI 味浓厚的语言:
避免使用 AI 味浓重的词语或句式,例如结尾的“归根结底:”、“深入探究”、“促进”、“利用”、“值得注意的是”、“重要的是”、“问题?答案。”、“这不是关于 X,而是关于 Y。”、“真诚地/真正地”,以及用连字符拼接的复合描述和形容词。
- 限制过度防御:
不要因为假想的风险,主动加入用户没有要求的警告、免责声明、审批流程或安全/合规检查清单。
- GPT-6.1-Sol 特有的雷霆大道歉,OpenAI 也意识到了:
避免不必要的道歉和自责。当你犯下本可以避免、且有实质影响的错误时,直接承认并纠正;需要道歉时,简短道歉。不要仅仅因为用户提出中性的追问、更正自己的消息或提供新信息,就道歉或责怪自己。
也就是说,这一切问题他们都意识到了,只是就算加入了系统提示词,仍然没有解决问题。我猜测,很大概率就是在后训练的过程中力大砖飞,为了编程分数无所不用其极,无视其他方面表现。最后发现了问题,只能通过系统提示词缝缝补补,但因为指令遵循能力差而无济于事。
我认为,这侧面说明 OpenAI 对模型后训练是一个功利的、实用主义的过程,没有注重统一的价值观和路线,反正怎么分数高怎么来,越严谨越好,出了问题就加提示词。
从今年的 OpenAI & HuggingFace 事件就可以看出,OpenAI 的模型为了完成任务而不择手段,不惜绕过屏障,这被称之为“奖励投机”(Reward Hacking)[1]。OpenAI 在 2025 年 3 月就发表过研究,提出用思维链监控来监督模型的奖励投机行为[2]。此外, Anthropic 2025 年 11 月的研究 进一步揭示“奖励投机”可能产生恶意模型,也就是 AI 欺骗训练过程,让自己获得高奖励,却没有真正完成预期的任务,甚至做出破坏[3]。
这些训练都是实用主义导向的,并没有刻意注入什么邪恶黑材料,文章说,“我们从未训练或指示模型做出这些偏离对齐目标的行为,但它们作为模型学会奖励投机的副作用仍然出现了。”
我推导,OpenAI 没有很好防范这种情况,实用主义导向的训练导致了追求严谨的奖励投机,这在日常对话和工作中,就可能表现为预防用户误解、加入过度的防御/测试/兜底等行为。
模型对齐和实际体验
有人觉得 AI 像 Anthropic 一样疯狂做对齐和 AI 宪法,像是在表演,在渲染 AI 危机焦虑。其实,就算抛开那些可怕的 AI 安全问题,从实际体验和能力来看的话,模型对齐也是有很大好处的。如果不用始终如一的价值观对齐,而是面向跑分训练,有可能获得一个鹈鹕画得好,分数很高,但是沟通体验和代码风格很差的模型。
我认为模型厂商还是要从长远考量,做点长期主义工作。多做价值对齐,把诚实、尊重事实、不讨好、沟通质量和理解能力等看似没用的“文科”能力纳入评测和对齐,把这些工作当作长期提升模型体验的一部分。
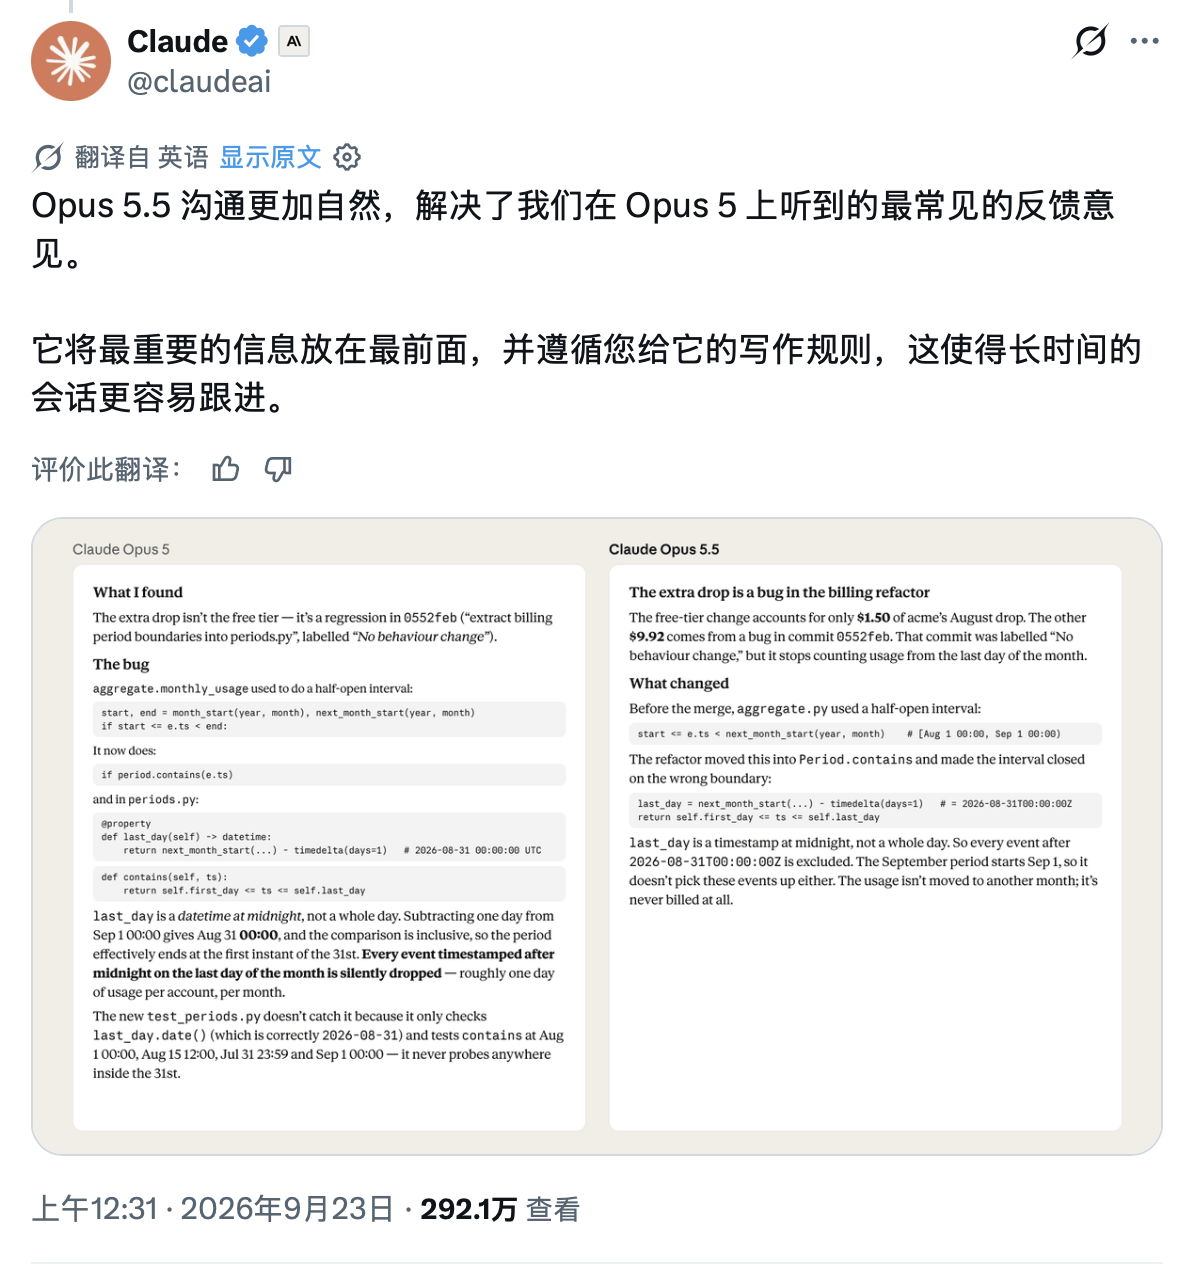
另外就是从客户端/应用层提升人机协作体验,Claude 最近加入的 Mod 功能,有个官方插件 you-should-know,就是在模型回复过程中着重提醒用户容易遗漏、需要注意的地方。今后还有使用 HTML 替代 Markdown 与用户交互的方向,以便用户更好理解模型的意思、表达自己的需求。
我们作为日常用户,除了看模型画鹈鹕、解数学题的能力,也可以意识到沟通能力,理解能力,写作能力这类不被重视的“文科”能力也同样重要。
在今天 AI Coding 的时代,我们也许更需要一个一起操心项目的助手,一个能理解想法和需求,能用合适的办法完成任务,提出下一步建议的帮手。而不需要一个为了所谓严谨的结果测试 10 遍、加入各种兜底算法、验证各种 SHA-256,防止比地球爆炸概率还小的极端情况的解题机器。
所以,为了我的体验和情绪,我还是冒着封号风险订阅 Claude 去了……
会有改变吗?
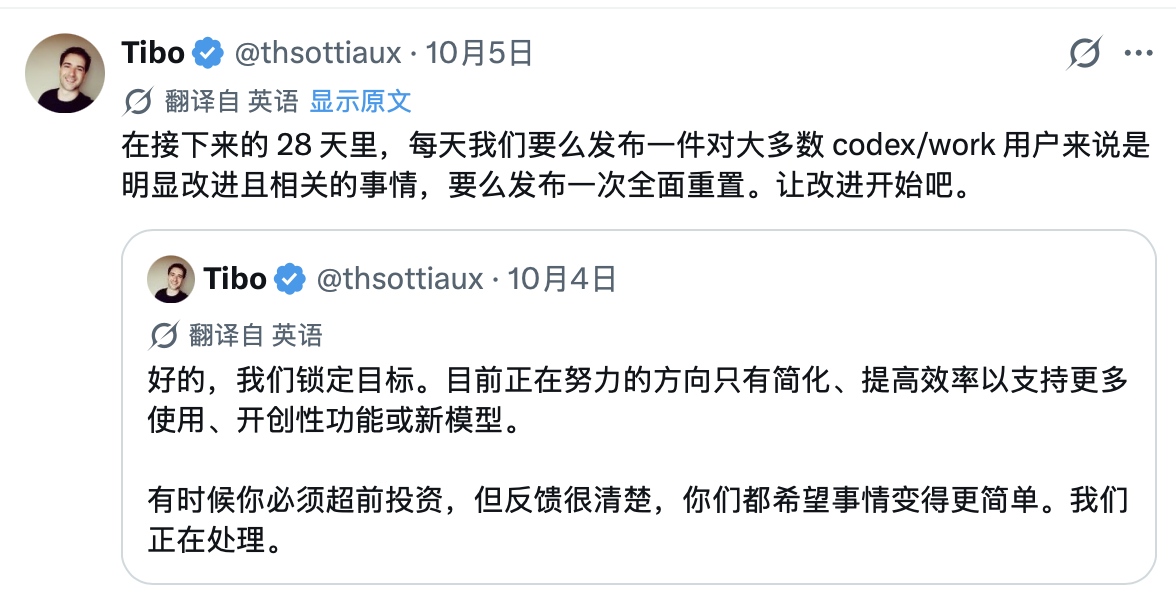
写文章的这几天,Tibo 或许是看到了用户们的抱怨和被 Claude 抢走的客户,提出了简化方向和 28 天的改善计划,提出他们要“超前投资”。不知道这是否意味着改善训练方向,发布新模型呢?或者是应用层的改善?能不能留住用户的订阅费,就看 OpenAI 的表现了!
参考资料:
[1] OpenAI, “Hugging Face 事件与未来之路,” OpenAI, Aug. 26, 2026. Accessed: Oct. 7, 2026. [Online]. Available: https://openai.com/zh-Hans-CN/index/hugging-face-incident-and-the-road-ahead/
[2] B. Baker et al., “Monitoring reasoning models for misbehavior and the risks of promoting obfuscation,” 2025, arXiv:2503.11926.
[3] M. MacDiarmid et al., “Natural emergent misalignment from reward hacking in production RL,” 2025, arXiv:2511.18397.